Poland KN09BQ
 EN
ESSB - wysoka jakość dźwięku w emisji SSB
Krótkofalarstwo Audio
Lepsza jakość i czytelność nadawanego głosu
Poradnik kieruję do osób zainteresowanych poprawą jakości dźwięku w transmisjach SSB. Postaram się wyjaśnić poszczególne etapy konfiguracji toru nadawczego: od doboru sprzętu, przez ustawienia mikrofonu i obróbkę sygnału audio, aż po pomiary, odsłuch i optymalizację parametrów toru audio.
Celem poradnika jest przekazanie wiedzy, która pozwoli Wam samodzielnie konfigurować tor nadawczy, świadomie dobierać ustawienia i uzyskiwać lepszą jakość oraz czytelność nadawanego głosu.
Należy pamiętać, że nie istnieją jedne uniwersalne ustawienia korekcji częstotliwościowej (EQ), które będą optymalne dla każdego operatora. Każdy głos ma inną charakterystykę, dlatego korekcję należy dobierać indywidualnie, uwzględniając jego barwę, rozkład energii w poszczególnych pasmach oraz sposób artykulacji.
Inaczej wygląda kwestia prawidłowej konfiguracji procesorów dynamiki. W ich przypadku istnieją ogólne zasady i zakresy ustawień, które można stosować niezależnie od charakteru głosu. Dotyczą one między innymi czasów ataku i powrotu, podtrzymania bramki szumów (hold), płynności otwierania i zamykania bramki oraz stopnia kompresji. Ich zadaniem jest zapobieganie niepożądanym efektom, takim jak obcinanie początków i końców słów, słyszalne pompowanie poziomu, agresywne i słyszalne działanie bramki czy zniekształcenia wynikające z nieprawidłowej obróbki sygnału.
Nie oznacza to, że wszystkie parametry można ustawić identycznie w każdym urządzeniu i w każdym QTH. Przykładowo próg otwarcia bramki (Threshold) zależy od poziomu sygnału głosu na wejściu oraz szumów otoczenia w danym miejscu. Zasady doboru czasów reakcji, podtrzymania i powrotu wynikają przede wszystkim z charakteru i rodzaju sygnału oraz pożądanego sposobu działania danego procesora.
Celem poradnika nie jest zatem przedstawienie gotowych i uniwersalnych ustawień do bezkrytycznego skopiowania, lecz wyjaśnienie, które parametry należy dobierać indywidualnie, a które można oprzeć na sprawdzonych zasadach prawidłowej konfiguracji.
Sprzęt i warunki pracy: co rzeczywiście ma znaczenie?
Zanim przejdziemy do konfiguracji i ustawień korekcji, kompresorów, limiterów oraz pozostałych procesorów audio, warto omówić kilka podstawowych kwestii dotyczących sprzętu. Nie będę skupiać się na szczegółowym porównywaniu mikrofonów i interfejsów audio, ponieważ temat ten jest szeroko opisany w innych poradnikach i na YouTube. Skoncentruję się na tym, na co rzeczywiście warto zwrócić uwagę podczas budowania toru nadawczego ESSB.
Transceiver i pasmo przenoszenia audio
Jeżeli zależy nam na eksperymentowaniu z ESSB i uzyskaniu szerokiego, naturalnie brzmiącego sygnału, warto wybrać transceiver umożliwiający odpowiednio szerokie ustawienie filtrów nadawczego i odbiorczego. W zależności od urządzenia i sposobu pracy może to być pasmo sięgające przykładowo od 20 Hz do 4-6 kHz.
Pamiętajmy, że nieprawidłowo przygotowany sygnał może brzmieć źle niezależnie od szerokości pasma. Ponadto w praktyce należy uwzględnić zalecenia dotyczące zajmowanego pasma, warunki panujące aktualnie na paśmie i możliwość odbioru takiego sygnału przez korespondenta.
Czy do dobrego dźwięku potrzebny jest drogi sprzęt audio?
Nie. Rozpoczęcie pracy nad jakością modulacji SSB nie wymaga zakupu najdroższych mikrofonów, interfejsów audio czy zewnętrznych procesorów dźwięku.
W wielu przypadkach różnica w cenie urządzeń jest znacznie większa niż różnica w jakości, którą będzie w stanie usłyszeć korespondent. Wielokrotnie można spotkać na pasmach operatorów korzystających z bardzo drogich, zaawansowanych zestawów, których modulacja brzmi gorzej niż sygnał osób używających sprzętu wielokrotnie tańszego, a czasem nawet mikrofonu dołączonego do radia.
Dlaczego tak się dzieje? Ponieważ jakość końcowego sygnału zależy nie tylko od klasy poszczególnych komponentów, ale również od ich prawidłowego ustawienia, akustyki pomieszczenia oraz umiejętności poprawnej oceny końcowego sygnału.
Droższy sprzęt może zapewnić określone korzyści, takie jak niższy poziom szumów własnych, większy zapas wzmocnienia, mniejsze zniekształcenia czy lepszą ergonomię. Nie oznacza to jednak, że korzyści te automatycznie przełożą się na lepszą zrozumiałość transmisji i brzmienie chwalone na pasmach.
Jakość odsłuchu lokalnego a jakość transmisji radiowej
Podczas konfiguracji toru audio często słuchamy własnego głosu bezpośrednio z komputera lub interfejsu audio. W takich warunkach możemy usłyszeć bardzo czysty sygnał, z dużym odstępem od szumu i niewielkimi zniekształceniami.
Odbiór sygnału przez radio wygląda jednak inaczej. Na rezultat wpływają: poziom sygnału docierającego do odbiornika, szumy pasma, zakłócenia, propagacja oraz parametry toru odbiorczego, takie jak na przykład AGC.
Dla przykładu: jeżeli nasz sygnał u korespondenta jest odbierany na poziomie S9, a szum tła również jest wysoki, rzeczywisty odstęp sygnału od szumu może być znacznie mniejszy niż podczas lokalnego odsłuchu w dobrze skonfigurowanym torze audio. W takich warunkach subtelne różnice między drogimi interfejsami czy mikrofonami mogą mieć mniejsze znaczenie niż prawidłowa korekcja, kontrola dynamiki i czytelność naszego głosu.
Warto pamiętać, że naszym celem nie jest wyłącznie uzyskanie pięknie brzmiącego sygnału podczas lokalnego odsłuchu. Istotne jest również zachowanie czytelności w rzeczywistych warunkach prowadzenia łączności i możliwie bliskie zbliżenie się do w miarę uniwersalnego brzmienia, które spełni swoją podstawową funkcję w różnych warunkach odbioru.
Interfejs audio i przedwzmacniacz mikrofonowy
Interfejs audio powinien zapewniać odpowiedni poziom szumów własnych, wystarczające wzmocnienie i odpowiedni zapas dynamiki. Nie musi to być jednak urządzenie z najwyższej półki cenowej.
Znaczenie parametrów przedwzmacniacza zależy między innymi od zastosowanego mikrofonu. Przykładowo Shure SM7B jest mikrofonem dynamicznym o stosunkowo niskiej czułości. Wymaga więc większego wzmocnienia niż wiele mikrofonów pojemnościowych i dynamicznych.
Jeżeli przedwzmacniacz ma zbyt mały zakres użytecznego wzmocnienia i jednocześnie wysoki poziom szumów własnych, ustawienie go blisko maksymalnego poziomu może sprawić, że szum przedwzmacniacza stanie się bardziej słyszalny. Samo wysokie ustawienie wzmocnienia nie oznacza jednak automatycznie powstawania szumów i zniekształceń. Pojawiają się one wtedy, gdy zostaną przekroczone możliwości danego urządzenia lub nieprawidłowo ustawimy poziom sygnału.
Dlatego przy doborze interfejsu warto zwrócić uwagę na rzeczywisty poziom szumów, dostępne wzmocnienie i jego zapas w odniesieniu do planowanego lub posiadanego mikrofonu. Nie kierujmy się jedynie ceną urządzenia.
Jaki transceiver wybrać?
Większość transceiverów SDR dobrze nadaje się do transmisji ESSB. Szeroki zakres regulacji filtrów nadawczych i odbiorczych pozwala przenosić zarówno niskie częstotliwości, jak i składowe powyżej 3 kHz, czasem nawet do 12 kHz.
Do popularnych konstrukcji należą transceivery FlexRadio, urządzenia ANAN oferowane przez Apache Labs oraz SunSDR Pro 2 firmy Expert Electronics. Ja sam korzystam z FlexRadio 6500 od ponad 12 lat.
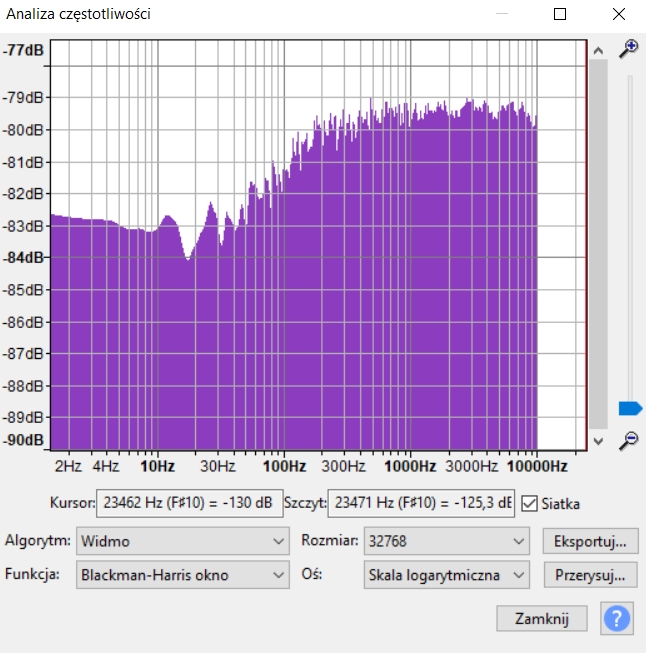
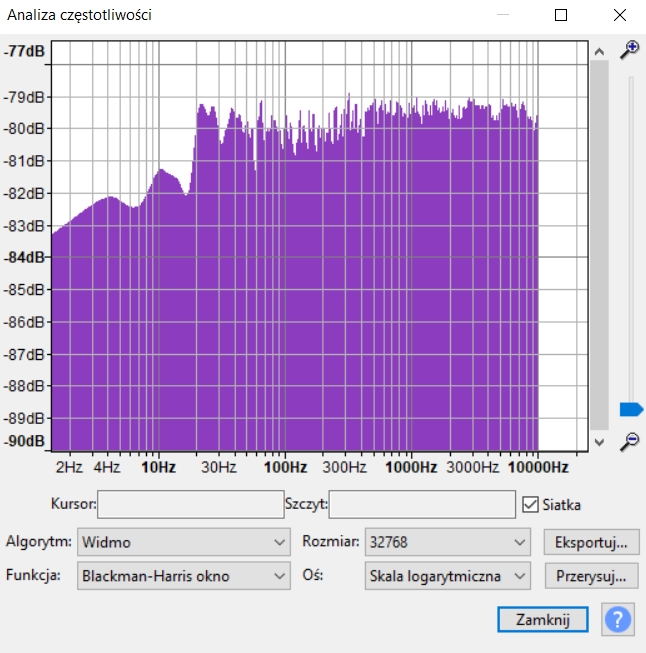
W Flex 6500 ważne jest ustawienie filtra odbiorczego, szczególnie gdy preferujemy większą liniowość toru odbiorczego. W zakładce Filters zalecam wybrać ustawienie Sharp zamiast Low Latency. W moich porównaniach zapewnia ono bardziej liniową odpowiedź filtra, choć może wiązać się z większą latencją. Poniżej zamieszczam wykresy porównujące oba ustawienia.
Dobór mikrofonu a akustyka pomieszczenia
Wybór mikrofonu powinien uwzględniać nie tylko jego charakterystykę, ale również warunki, w jakich będzie używany.
Mikrofony pojemnościowe mogą zapewniać wysoką czułość, niski poziom szumów własnych i szczegółowe odwzorowanie głosu. Dobrze sprawdzają się w pomieszczeniach, w których ograniczono odbicia dźwięku i hałas otoczenia. Nie oznacza to jednak, że każdy mikrofon pojemnościowy będzie lepszy od dynamicznego. Dużo zależy od konkretnego modelu.
W pomieszczeniu nieprzygotowanym akustycznie mikrofon pojemnościowy może wyraźnie rejestrować odbicia od ścian, sufitu, blatu biurka i innych twardych powierzchni. Mikrofon dynamiczny, szczególnie kierunkowy i używany z niewielkiej odległości, może w takich warunkach ułatwić uzyskanie korzystnej proporcji między głosem a dźwiękami pomieszczenia. Nie eliminuje jednak problemu odbić.
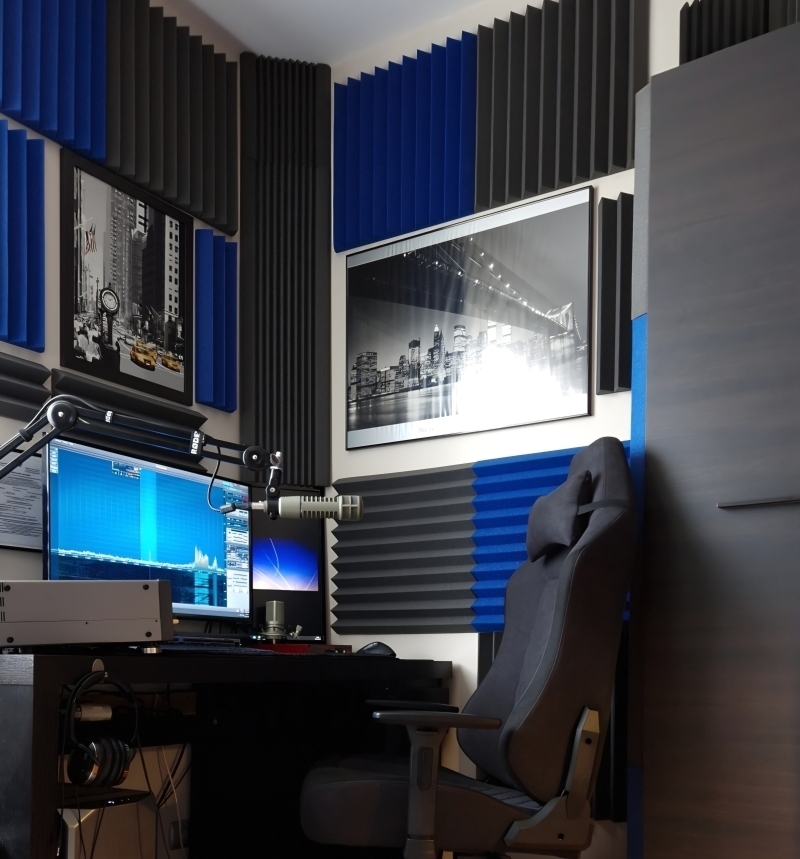
Niezależnie od rodzaju mikrofonu warto zadbać o akustykę w naszym radio shacku. Szczególnie przydatne jest ograniczenie silnych odbić od dużych, płaskich powierzchni za pomocą odpowiednio dobranych materiałów pochłaniających dźwięk. Należy przy tym pamiętać, że cienkie pianki akustyczne pochłaniają głównie średnie i wysokie częstotliwości i nie rozwiązują skutecznie problemów z niskim basem. Skuteczna adaptacja akustyczna pomieszczenia wymaga dopasowania materiałów do zakresu częstotliwości, który chcemy wytłumić. Można stosować pianki, wełnę lub panele akustyczne. W rogach sprawdzą się pułapki basowe.
Podsumowanie
Na początku naszej przygody z ESSB nie trzeba inwestować ogromnych pieniędzy w sprzęt z najwyższej półki. W pierwszej kolejności warto zadbać o umiejętność prawidłowej konfiguracji toru audio, czyli odpowiedni poziom sygnału, kontrolę dynamiki, właściwą korekcję i warunki akustyczne w pomieszczeniu.
Dopiero gdy te składowe zostaną opanowane, można zastanowić się, czy wymiana konkretnego komponentu rzeczywiście przyniesie istotną poprawę. W praktyce dobrze skonfigurowany, rozsądnie dobrany zestaw może zapewnić bardzo wysoką jakość modulacji bez konieczności ponoszenia dużych kosztów.
Zanim rozpoczniesz konfigurację audio, zadbaj o warunki odsłuchu
Zanim przejdziemy do praktycznego ustawiania korekcji częstotliwościowej (EQ), kompresorów, limiterów i pozostałych procesorów audio, warto zwrócić uwagę na jedną istotną, choć często pomijaną kwestię: brzmienie, które słyszymy podczas odsłuchu, nie zależy wyłącznie od ustawień naszego toru nadawczego.
Każdy korespondent ocenia sygnał przez własny tor odbiorczy, którego charakterystyka oraz ustawienia filtrów i AGC są nam nieznane. Na końcowy efekt wpływają także słuchawki lub głośniki, poziom odsłuchu, zakłócenia i propagacja. Głos brzmiący naturalnie na jednym transceiverze może na innym wydawać się zbyt ciemny, zbyt jasny, ostry lub pozbawiony pełni. Nie da się zadowolić wszystkich, ale można dążyć do brzmienia, które sprawdzi się w różnych warunkach odbioru.
Odbiornik o możliwie neutralnej charakterystyce
Do oceny barwy modulacji najlepiej wykorzystać odbiornik o możliwie neutralnej i znanej charakterystyce. Jeśli nie dysponujemy odbiornikiem o zmierzonej, płaskiej charakterystyce, warto przynajmniej wyeliminować zbędne przetwarzanie sygnału po stronie odbiorczej. Na czas strojenia wyłącz korektor barwy, redukcję szumów (Noise Reduction), Noise Blanker, filtry notch (chyba że są potrzebne do usunięcia konkretnego zakłócenia) oraz dodatkowe procesory audio, które mogą zmieniać charakterystykę lub dynamikę dźwięku.
Neutralny odbiornik nie oznacza idealnie płaskiego toru odsłuchowego - własną charakterystykę mają także przetwornik cyfrowo-analogowy, wzmacniacz słuchawkowy, słuchawki i głośniki. Porównując ustawienia, korzystaj z tego samego, niezmienianego toru odsłuchowego.
AGC a dynamika i naturalność głosu
Automatyczna regulacja wzmocnienia (AGC) dostosowuje wzmocnienie do poziomu odbieranego sygnału. Jej charakterystyka czasowa, zwłaszcza szybkość reakcji na wzrost i spadek poziomu, może wpływać na subiektywną ocenę dynamiki i głośności fragmentów wypowiedzi. Przy bardzo szybkiej lub agresywnej regulacji głos może wydawać się mniej naturalny, bardziej natarczywy albo nierówny; działanie AGC wpływa też na odbiór szumów w przerwach między słowami, co może istotnie wpływać na ocenę brzmienia.
Podczas porównywania ustawień modulacji utrzymuj ustawienia odbiornika, a przede wszystkim poziom odsłuchu, bez zmian. Zalecam wolniejsze AGC. Ważne, by AGC nie utrudniało rozpoznania zmian, które wprowadzamy.
Dlaczego warto korzystać z lokalnego odbiornika?
Do podstawowej oceny własnej modulacji najlepiej wykorzystać odbiornik znajdujący się w tej samej lokalizacji co nadajnik, pod warunkiem zapewnienia bezpiecznego poziomu sygnału na jego wejściu.
Takie rozwiązanie ogranicza wpływ propagacji na odbierane widmo naszego sygnału i zapewnia dobry stosunek sygnału do szumu.
Dlaczego odbiór na pasmach HF może zafałszować ocenę barwy?
Szczególną ostrożność zachowaj podczas oceny modulacji na pasmach przez odbiornik zdalny lub WebSDR. Propagacja, wielodrogowość i selektywny zanik mogą nierównomiernie tłumić składowe sygnału SSB, przez co część pasma będzie odbierana mocniej, a inna słabiej. Barwa głosu może więc zmieniać się kilkukrotnie wraz z warunkami odbioru w czasie nawet jednej wypowiedzi.
Jeśli na podstawie takiego odsłuchu zaczniesz korygować EQ, możesz nieświadomie kompensować charakterystykę kanału propagacyjnego zamiast własnego toru nadawczego. Odbiór zdalny i WebSDR są przydatne do sprawdzania, jak sygnał dociera w różne miejsca przy różnych warunkach propagacji i odbioru, ale nie powinny być jedyną podstawą precyzyjnego ustawiania korekcji.
Odsłuchuj nagranie, a nie własny głos podczas mówienia
Ocenianie korekcji podczas mówienia do mikrofonu utrudnia, a czasem uniemożliwia wiarygodne porównanie. Słyszysz wtedy własny głos przez słuchawki i przez przewodnictwo kostne, a jednocześnie kontrolujesz artykulację, oddech i sposób mówienia, często pod dyktando zamierzonego efektu. Warunki te różnią się od odsłuchu nagrania, a Twój głos może zmieniać się między próbami.
Zrób tak: nagraj własną modulację bez korekcji i innych procesorów, najlepiej do pliku WAV. Wybierz kilka zdań wypowiedzianych naturalnym głosem, a następnie odtwarzaj ten sam fragment w pętli podczas wprowadzania zmian. Dzięki temu porównasz ustawienia na identycznym materiale. Zadbaj, by nagranie nie było przesterowane. Ważne, aby poziom odtwarzania pozostawał stały, ponieważ zmiana głośności mocno wpływa na ocenę barwy dźwięku.
Ślepy test - sprawdź, czy rzeczywiście słyszysz poprawę
Ważną zasadą jest weryfikowanie wprowadzonych zmian w ślepym teście odsłuchowym. Podczas pracy nad korektorem łatwo ulec sugestii, że skoro wykonaliśmy określoną zmianę, to sygnał powinien brzmieć lepiej.
Przykładowo obniżamy poziom w okolicy 250 Hz, ponieważ wydaje nam się, że właśnie tam znajduje się przyczyna zamulenia głosu. Po zmianie słuchamy sygnału i odnosimy wrażenie, że jest czytelniejszy. Następnie wykonujemy kolejną korekcję i ponownie oceniamy rezultat. Problem polega na tym, że przez cały czas wiemy, co zmieniamy, i możemy nieświadomie dopasowywać ocenę do własnych oczekiwań i wprowadzonych zmian.
Aby ograniczyć ten wpływ, warto porównywać dwie wersje sygnału bez wiedzy, która z nich jest aktualnie odtwarzana. Jeśli nie mamy drugiej osoby, która może przygotować porównanie, można wykorzystać losową kolejność odtwarzania i ukryć ustawienia, o ile używane EQ na to pozwala.
Podczas testu należy wybierać wersję, która rzeczywiście brzmi lepiej, a nie tę, która odpowiada naszym wcześniejszym przewidywaniom. Warto wykonać co najmniej kilka prób.
Możliwe wyniki są różne:
- Wyraźna i powtarzalna preferencja jednej wersji - to argument, że zmiana ma słyszalny i korzystny efekt.
- Brak pewności lub podobna ocena obu wersji - różnica może być zbyt mała, aby miała praktyczne znaczenie.
- Preferowanie w ślepym teście wersji, którą wcześniej ocenialiśmy jako gorszą - to sygnał, że wcześniejsza ocena mogła być częściowo wynikiem sugestii lub oczekiwań.
Pamiętajmy również o wyrównaniu poziomów głośności. Jeśli jedna wersja jest choć trochę głośniejsza od drugiej, może zostać oceniona jako pełniejsza lub bardziej wyrazista, nawet jeśli sama korekcja jej nie poprawiła. Porównywane wersje powinny więc mieć możliwie jednakową głośność, a materiał, tor odsłuchowy i pozostałe ustawienia powinny pozostać niezmienione.
Celem korekcji nie jest uzyskanie wykresu, który wygląda lepiej, ani osiągnięcie efektu, który wydaje nam się lepszy podczas obserwowania zmian. Celem jest uzyskanie rzeczywistej, słyszalnej poprawy, gdy nie wiemy, kiedy następuje zmiana.
Jeśli nie potrafimy wiarygodnie odróżnić wersji skorygowanej od oryginalnej albo nie wybieramy jej konsekwentnie w ślepym teście, nie ma podstaw, aby uznać tę korekcję za poprawę. Warto wtedy rozważyć, czy dodatkowa ingerencja jest w ogóle potrzebna lub czy wdrożona zmiana nie jest na tyle mała, że jej wykrycie w ślepym teście nie jest możliwe.
Cyfrowa obróbka audio czy zewnętrzne procesory sprzętowe?
Jednym z pierwszych wyborów, przed którymi staniemy podczas budowania toru nadawczego, jest decyzja, czy korzystać z zewnętrznych procesorów audio, takich jak kompresory, limitery i korektory firmy Behringer oraz innych producentów, czy też oprzeć cały proces na oprogramowaniu komputerowym i wtyczkach VST.
Osobiście zdecydowanie preferuję obróbkę programową, ponieważ zapewnia mi dużą elastyczność, wygodę obsługi i precyzyjną kontrolę nad poszczególnymi etapami modyfikacji dźwięku.
Zalety obróbki programowej
Korzystanie z oprogramowania wyposażonego w odpowiednie wtyczki audio daje wiele praktycznych możliwości:
- Swobodne zmienianie kolejności procesorów - możemy łatwo zdecydować, czy korekcja ma znajdować się przed kompresorem, czy za nim, a także dodawać i usuwać kolejne etapy obróbki.
- Precyzyjna regulacja parametrów - wtyczki programowe często oferują szeroki zakres ustawień, dokładne wartości liczbowe i wizualizację działania procesora.
- Wygodne zarządzanie presetami - możemy przygotować różne konfiguracje dla różnych warunków pracy, zapisać je i przywoływać praktycznie jednym kliknięciem.
- Kontrola poziomów sygnału - łatwo monitorować poziom na wejściu i wyjściu poszczególnych wtyczek oraz prawidłowo ustawiać gain staging, czyli przebieg wzmocnienia całego toru.
- Łatwa i tania rozbudowa - dodanie kolejnego korektora, kompresora wielopasmowego, de-essera czy limitera nie wymaga zakupu kolejnego urządzenia fizycznego ani łączenia go kablami.
Istotną zaletą jest również możliwość szybkiego porównywania ustawień. Możemy przygotować kilka wariantów korekcji i kompresji, przełączać się między nimi i oceniać brzmienie. Ułatwia to eksperymentowanie i pozwala znacznie szybciej znaleźć ustawienia, które nam odpowiadają.
Szumy i jakość sygnału
Obróbka programowa może również ułatwić utrzymanie niskiego poziomu szumów w całym torze audio. Nie oznacza to jednak, że samo zastosowanie wtyczek automatycznie zapewnia lepszy stosunek sygnału do szumu.
W przypadku zewnętrznych procesorów analogowych każdy dodatkowy stopień toru może wprowadzać własne szumy i zniekształcenia. Znaczenie mają również poziomy sygnału, jakość układów elektronicznych, połączenia oraz sposób prowadzenia masy i zasilania.
W torze programowym po konwersji sygnału do postaci cyfrowej można przeprowadzić wiele operacji bez konieczności ponownego przechodzenia przez kolejne analogowe stopnie wzmocnienia. Ogranicza to liczbę potencjalnych źródeł dodatkowego szumu.
Warto również pamiętać, że wtyczki cyfrowe nie są całkowicie wolne od ograniczeń. Niewłaściwy gain staging, przesterowanie cyfrowe, zbyt duże obciążenie procesora lub błędna konfiguracja mogą powodować problemy z jakością i stabilnością pracy.
AudioMulch i wtyczki FabFilter - rozwiązanie, które polecam
W swoim torze nadawczym rekomenduję wykorzystanie programu AudioMulch oraz wtyczek FabFilter VST, w tym korektora Pro-Q 3, kompresora Pro-C 2 i limitera Pro-L 2. Konkretne narzędzia dobieramy oczywiście do własnych potrzeb - nie każdy sygnał wymaga zastosowania wszystkich tych procesorów.
Takie rozwiązanie pozwala zbudować kompletny, elastyczny tor przetwarzania audio w środowisku programowym. Możemy dokładnie kontrolować kolejność procesorów, regulować ich parametry, zapisywać konfiguracje i wprowadzać zmiany bez fizycznego przepinania przewodów.
Dodatkową zaletą jest możliwość wizualnej kontroli naszego sygnału, co ułatwia analizę jego poziomu, dynamiki i charakterystyki częstotliwościowej. Dzięki temu ustawienia można dopracowywać nie tylko na podstawie odsłuchu, ale również obserwacji działania poszczególnych etapów obróbki dźwięku.
A co z zewnętrznymi procesorami?
Oczywiście zastosowanie zewnętrznych procesorów analogowych lub cyfrowych również jest możliwe. Sam korzystałem wcześniej z tego rodzaju urządzeń i nie ma przeszkód, aby zbudować na nich dobrze działający tor nadawczy.
W mojej ocenie jest to jednak rozwiązanie mniej elastyczne i bardziej kłopotliwe w codziennej obsłudze. Zmiana kolejności urządzeń, konfiguracja kilku wariantów ustawień czy precyzyjne porównywanie parametrów mogą wymagać więcej czasu i czynności niż w przypadku oprogramowania. Zakres dostępnych regulacji zależy przy tym od konkretnego urządzenia - niektóre procesory sprzętowe oferują bardzo rozbudowane możliwości, inne są znacznie bardziej ograniczone.
Po przejściu na obróbkę programową nie widzę dla siebie praktycznego powodu, aby wracać do rozbudowanego zestawu zewnętrznych procesorów. Oprogramowanie zapewnia mi większą swobodę konfiguracji, łatwiejszą kontrolę nad całym torem i znacznie wygodniejszą pracę.
Podsumowanie
Jeżeli dopiero budujesz swój tor nadawczy, warto rozważyć obróbkę programową. Oczywiście nie jest ona darmowa, ale w relacji ceny do możliwości w mojej ocenie wypada zdecydowanie korzystniej.
Konfiguracja łańcucha audio
Po zapoznaniu się z podstawami oraz wybraniu docelowej szerokości pasma nadawania możemy przejść do konfiguracji poszczególnych elementów toru audio. Omówimy funkcję każdego procesora, znaczenie jego parametrów oraz praktyczne zasady ustawiania ich podczas pracy z głosem w transmisji SSB.
W moim torze nadawczym staram się ograniczać liczbę procesorów do niezbędnego minimum. Zależy mi na ograniczeniu zbędnej latencji, zachowaniu przejrzystości całego toru oraz uzyskaniu naturalnego, miękkiego i gładkiego brzmienia, bez nadmiernego przetwarzania głosu.
Mój łańcuch audio składa się z pięciu podstawowych elementów:
- FabFilter Pro-G - bramka szumów.
- FabFilter Pro-Q 3 - korektor częstotliwościowy.
- FabFilter Pro-DS (Mono) - de-esser.
- FabFilter Pro-MB - kompresor wielopasmowy.
- FabFilter Pro-L 2 - limiter końcowy.
Przed rozpoczęciem konfiguracji zakładamy, że poziomy sygnału są prawidłowo ustawione, na wejściu nie występuje przesterowanie, a przedwzmacniacz mikrofonowy pracuje w odpowiednim zakresie wzmocnienia. Żaden procesor nie naprawi sygnału, który został już zniekształcony na wejściu toru.
1. FabFilter Pro-G - bramka szumów
Bramka szumów służy do ograniczania poziomu sygnału w przerwach między wypowiedziami. Jej głównym zadaniem jest zmniejszenie słyszalności szumu otoczenia i innych dźwięków tła wtedy, gdy nie mówimy.
Prawidłowo skonfigurowana bramka powinna działać możliwie dyskretnie: nie obcinać początków słów, końcówek wyrazów ani cichych sylab i nie powodować słyszalnego, skokowego otwierania oraz zamykania toru. Choć jej ustawienie należy do prostszych etapów konfiguracji toru audio, na pasmach często można usłyszeć bramki działające zbyt agresywnie, czyli wycinające głos przy każdej krótkiej przerwie w wypowiedzi. Naturalna mowa nie przebiega zero-jedynkowo i nie przypomina robotycznego wypowiadania pojedynczych słów. Dlatego stosuje się podtrzymanie (Hold) i odpowiednio dobrany czas zamykania (Release). Wtedy bramka pozostaje otwarta między krótkimi przerwami, a następnie łagodnie wycisza sygnał, zamiast gwałtownie go odcinać.
Poniższe wartości są moimi ustawieniami wyjściowymi dla mowy. Należy je traktować jako punkt odniesienia, a nie uniwersalny preset dla każdego mikrofonu i pomieszczenia.
Proponowane ustawienia
| Parametr | Wartość | Funkcja i uzasadnienie |
|---|---|---|
| Ratio | 6,5:1 | Określa stopień tłumienia sygnału poniżej progu działania bramki, zgodnie z charakterystyką procesora. |
| Range | 30 dB | Określa maksymalny zakres tłumienia po zamknięciu bramki. Pozwala znacząco ograniczyć szum, ale nie musi oznaczać całkowitego wyciszenia sygnału. |
| Attack | 1 ms | Bardzo szybkie otwieranie bramki po przekroczeniu progu, ograniczające ryzyko utraty początków wypowiedzi. |
| Hold | 250 ms | Podtrzymuje otwarcie bramki po spadku sygnału poniżej progu, ograniczając niepożądane zamykanie między sylabami i krótkimi przerwami. |
| Knee | 5 dB | Zapewnia łagodniejsze przejście w obszarze progu, dzięki czemu działanie bramki może być mniej gwałtowne. |
| Release | 550 ms | Spowalnia zamykanie bramki, pozwalając naturalnie wybrzmieć końcówkom słów i ograniczając efekt nagłego zaniku tła. |
| Look Ahead | 2 ms | Pozwala detektorowi zareagować przed pojawieniem się sygnału na wyjściu, zależnie od implementacji procesora. Może pomóc zachować początek wypowiedzi, ale wprowadza dodatkową latencję. |
| Oversampling | 2× | Zwiększa częstotliwość wewnętrznego przetwarzania w obsługiwanych trybach. W przypadku samej bramki korzyść może być niewielka, dlatego warto ocenić, czy ustawienie jest potrzebne. |
Próg otwarcia - Threshold
W powyższej tabeli celowo nie podaję jednej wartości progu otwarcia. Threshold należy dobrać do rzeczywistego poziomu głosu i szumu tła w konkretnym miejscu.
Próg powinien być ustawiony tak, aby bramka otwierała się pewnie podczas normalnej mowy, również przy cichszych fragmentach, a jednocześnie ograniczała tło w przerwach. Jeżeli ustawimy go zbyt wysoko, bramka może obcinać ciche początki słów i końcówki wypowiedzi. Jeżeli ustawimy go zbyt nisko, może pozostawać otwarta przez większość czasu i nie spełniać swojej funkcji.
Jak sprawdzić, czy bramka działa prawidłowo?
Po ustawieniu parametrów należy przetestować kilka sytuacji:
- ciche rozpoczęcie wypowiedzi;
- normalną mowę z różną dynamiką;
- końcówki słów wypowiadane coraz ciszej;
- krótkie przerwy między zdaniami;
- dłuższą ciszę między wypowiedziami.
Jeżeli początek słowa znika, należy sprawdzić przede wszystkim próg otwarcia i szybkość reakcji bramki. Jeżeli końcówki są obcinane, warto obniżyć próg lub wydłużyć podtrzymanie i czas zamykania.
Ważne jest również, aby nie traktować bramki jako narzędzia do usuwania szumu podczas mówienia. Gdy bramka jest otwarta, szum nadal przechodzi przez tor. Jego ograniczenie podczas wypowiedzi wymaga poprawy warunków akustycznych pomieszczenia.
Bramka powinna pracować w tle, a jej działania nie powinno się zauważać podczas normalnego odsłuchu.
2.1. Poznaj charakter swojej modulacji
Zanim jednak zaczniemy dodawać filtry i zmieniać poziomy poszczególnych pasm, warto przynajmniej w podstawowym stopniu poznać charakter własnego głosu. Dzięki temu korekcja nie będzie przypadkowym eksperymentowaniem, lecz świadomym procesem opartym na obserwacji wykresu i odsłuchu.
Na początek zalecam nagranie własnego głosu przez około 30 sekund, na przykład w programie Audacity. Podczas nagrania należy mówić normalnie, w naturalnym tempie i z typową dla siebie głośnością.
Nagranie powinno być wykonane bez korekcji częstotliwościowej, kompresji, limitera i innych efektów. Chodzi o uzyskanie możliwie nieprzetworzonego sygnału, który pozwoli nam przyjrzeć się naturalnemu rozkładowi energii w głosie.
Następnie należy przeanalizować widmo nagrania. Pozwoli nam to wstępnie określić, w jakich zakresach znajduje się najwięcej energii, gdzie występują wyraźne szczyty oraz które pasma mogą wymagać dokładniejszego sprawdzenia podczas odsłuchu.
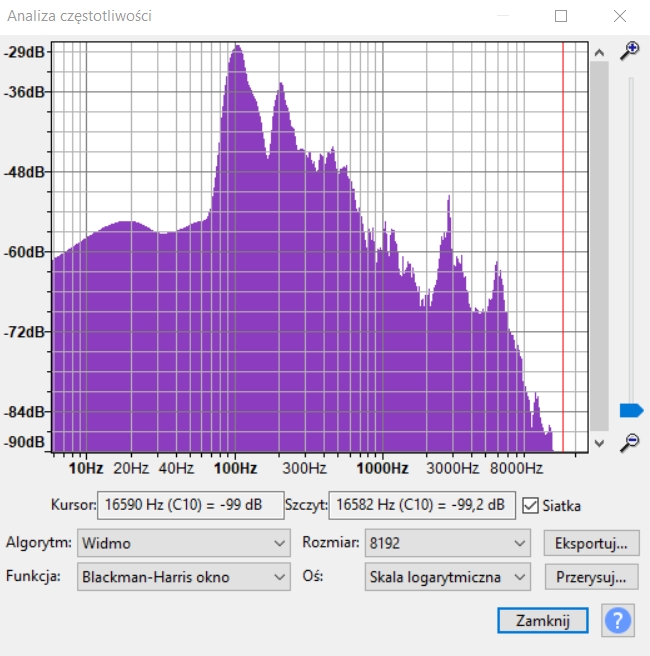
Taki wykres nie jest gotową receptą na korekcję, ale może być bardzo przydatnym drogowskazem. Ułatwia sformułowanie hipotez dotyczących przyczyn niepożądanego brzmienia, które następnie weryfikujemy za pomocą korektora i odsłuchu.
Przykładowo, jeżeli w widmie wyraźnie zaznaczają się składowe w okolicy 100 Hz i 200 Hz, warto sprawdzić, czy niższe częstotliwości nie dominują nad pozostałą częścią głosu. Jeżeli 200 Hz jest drugą harmoniczną składowej podstawowej 100 Hz, może ona wnosić istotną część energii w niższym środku. W zależności od pozostałych proporcji widma może to przyczyniać się do wrażenia dudnienia, nadmiernej masy lub zamulenia modulacji.
Należy jednak pamiętać, że sam szczyt na wykresie nie oznacza automatycznie problemu. Harmoniczne są naturalnym składnikiem głosu, a analizowany fragment może obejmować wiele dźwięków o różnych częstotliwościach podstawowych. Dlatego nie należy wycinać każdej wyraźnej składowej tylko dlatego, że jest widoczna na wykresie.
Analiza widma ma wskazać obszary warte sprawdzenia, a nie zastąpić odsłuch. Ostatecznie to porównanie brzmienia przed korekcją i po niej pozwala ocenić, czy wprowadzone zmiany rzeczywiście poprawiają czytelność i naturalność głosu.
Dlaczego duża różnica na wykresie daje małą różnicę w odsłuchu?
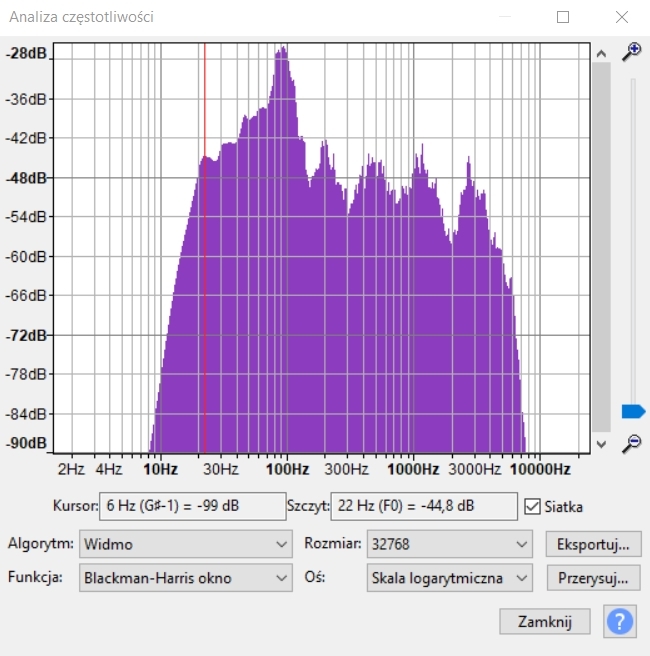
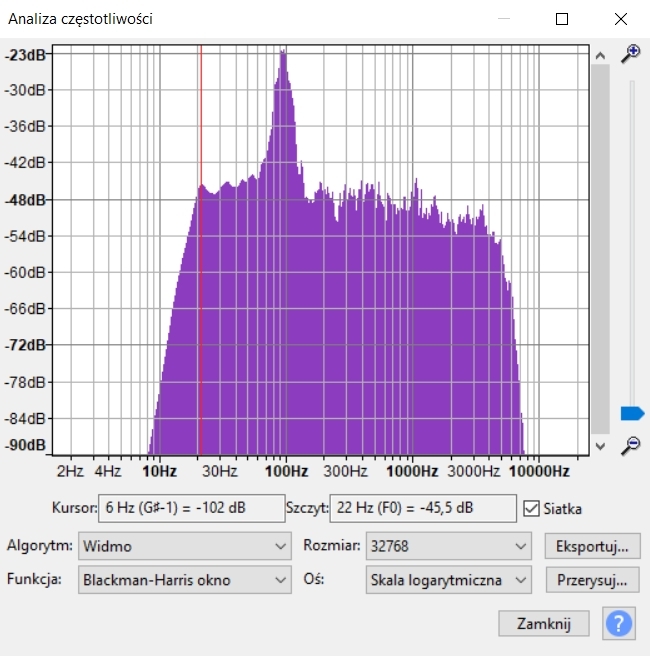
Może być kilka przyczyn tego zjawiska:
- Ucho nie ocenia każdej częstotliwości niezależnie. Słuch odbiera dźwięk w pasmach, a zmiana energii w jednym zakresie może wpływać na to, jak odbieramy zakresy sąsiednie. Płaska linia na wykresie nie jest uniwersalnym wzorcem naturalnego brzmienia, a widoczna różnica nie przekłada się wprost na równie dużą zmianę barwy podczas odsłuchu.
- Tor nadawczy i odbiorczy kształtują dźwięk. Sygnał przechodzi przez tor nadawczy i odbiorczy, a następnie przez przetworniki, karty dźwiękowe oraz słuchawki lub głośniki. Każdy z tych elementów wpływa na to, co ostatecznie słyszysz, dlatego odsłuch może różnić się od obrazu widma analizowanego lokalnie lub na Twoim odbiorniku SSB.
- Korekcja może poprawić równowagę tonalną bez radykalnej zmiany barwy. Widmo pokazuje poziom energii w funkcji częstotliwości, ale nie przedstawia bezpośrednio jej zmian w czasie. Dwa nagrania mogą mieć wyraźnie różne widma uśrednione, a jednocześnie zachowywać podobne cechy barwowe i brzmieniowe.
Dlatego duża różnica na wykresie może oznaczać stosunkowo niewielką zmianę w odsłuchu. Analizator pokazuje, co zmieniło się w sygnale, a słuch ocenia percepcyjne znaczenie tej zmiany. Te dwie rzeczy nie są ze sobą liniowo powiązane.
Wyrównanie widma może więc być pomiarowo duże, a brzmieniowo subtelne. Nie ma w tym sprzeczności.
2.2. Nie podbijaj automatycznie pasma, którego pozornie brakuje
Podczas kształtowania barwy należy również uwzględnić zjawiska psychoakustyczne. Sposób, w jaki odbieramy głos, zależy nie tylko od poziomu poszczególnych częstotliwości, lecz także od proporcji pomiędzy nimi. Nadmiar energii w jednym zakresie może sprawić, że pozostałe składowe będą odbierane jako mniej wyraźne.
Przykładowo, jeśli w głosie dominuje niższy środek, modulacja może sprawiać wrażenie zamulonej, przytłumionej lub „puszkowatej”. Naturalnym odruchem może być wówczas podbicie wysokich częstotliwości w celu uzyskania większej jasności. Nie zawsze jest to jednak najlepsze rozwiązanie.
Czasami wystarczy ograniczyć nadmiar energii w problematycznym zakresie, aby pozostałe części stały się bardziej wyraźne. Po odpowiednim zmniejszeniu dominującego środka może się okazać, że zarówno dół, jak i góra są już wystarczająco słyszalne - bez konieczności dodatkowego podbijania tych pasm.
Nie oznacza to, że podbijanie częstotliwości jest błędem. Bywa uzasadnione, jeśli określony zakres rzeczywiście wymaga wzmocnienia. Warto jednak sprawdzić, czy problem nie wynika z nadmiaru innej części widma.
Zanim podbijesz jakieś pasmo, sprawdź, czy lepszy efekt można uzyskać przez ograniczenie zakresu, który nadmiernie dominuje.
2.3. Od czego zacząć korekcję?
Istnieją pewne uniwersalne zasady korekcji, które pomagają uniknąć przypadkowego i złego ustawiania EQ. Warto jednak rozróżnić wyrównanie charakterystyki względem własnej sensownej krzywej docelowej od dążenia do idealnie płaskiej linii. Pierwsze może być dobrą metodą, drugie nie zawsze prowadzi do poprawnego brzmienia.
- Najpierw usuwaj nadmiary, dopiero później rozważaj podbicia. Jeśli w okolicach 200 Hz występuje nadmierna energia i słyszysz efekt pudełkowy, ograniczenie tego pasma jest zwykle bardziej racjonalne niż podbijanie kilku innych zakresów w celu zamaskowania problemu.
- Nie twórz lokalnych ekstremów bez konkretnego powodu. Filtr o dużym Q może utworzyć wąski pik albo głęboki dołek. Jeśli nie odpowiada on rzeczywistemu problemowi, może nadać głosowi nienaturalną barwę i zwiększyć wrażliwość brzmienia na drobne różnice w głosie.
- Korekcja powinna być możliwie gładka. Jeśli nie masz konkretnego powodu do zastosowania wąskiego filtra, łagodna zmiana szerokopasmowa zwykle jest bezpieczniejszym punktem wyjścia niż seria ostrych podbić i wycięć.
- Charakterystyka docelowa nie musi być płaska. Dla mowy nadawanej przez SSB często sensowna jest charakterystyka stopniowo opadająca ku wyższym częstotliwościom. Jej nachylenie zależy jednak od szerokości pasma, głosu i pożądanego brzmienia.
2. FabFilter Pro-Q 3 - korektor częstotliwościowy
Dochodzimy do zagadnienia, które prawdopodobnie najbardziej interesuje osoby chcące poprawić brzmienie swojej modulacji - korekcji barwy głosu.
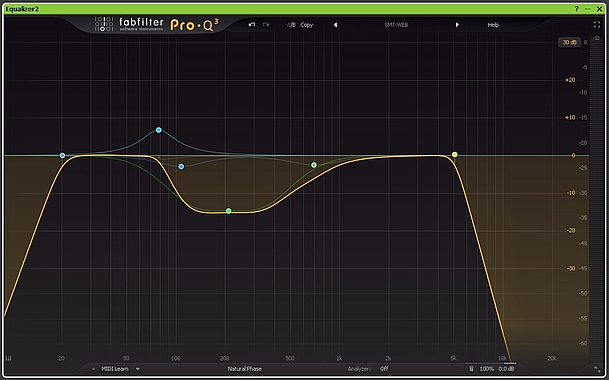
Zalecane wstępne ustawienia filtrów equalizera
- Typ filtra: Bell.
- Nachylenie: 12 dB/okt.
- Tryb fazy: Natural Phase.
- Gain-Q: włączone.
- Częstotliwość filtra dolnozaporowego: 20 Hz.
W moim torze nie widzę potrzeby stosowania trybu Linear Phase przy monofonicznym sygnale przeznaczonym do emisji SSB. Nie dostrzegam tu korzyści, która uzasadniałaby dodatkową latencję, dlatego jako ustawienie wyjściowe wybieram Natural Phase.
Funkcja Gain-Q wpływa na wzajemną zależność wzmocnienia i szerokości filtra typu Bell. Przy zwiększaniu wzmocnienia filtr staje się nieco węższy, a przy bardzo wąskim ustawieniu Q dodawane jest niewielkie wzmocnienie. Ma to zapewnić bardziej naturalną interakcję tych parametrów, zbliżoną do działania klasycznych korektorów. Opcja wpływa wyłącznie na kształt filtrów Bell. Jeśli chcesz regulować Gain i Q niezależnie, wyłącz Gain-Q.
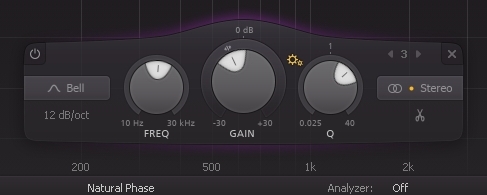
Dynamiczna kompensacja basu (Dynamic Bass Compensation)
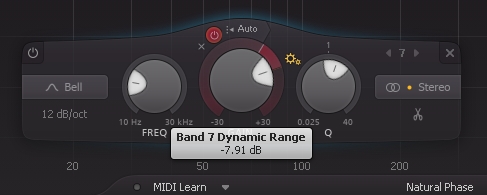
W FabFilter Pro-Q 3 można wykorzystać korekcję dynamiczną, aby dodać głosowi masy w cichszych fragmentach, a jednocześnie ograniczyć nadmiar niskich częstotliwości podczas głośniejszej mowy. Przykładowo można ustawić filtr w okolicy 100 Hz, dodać statyczne podbicie, a następnie zastosować ujemny zakres dynamiki. Gdy energia w tym paśmie przekroczy próg, filtr zacznie zmniejszać podbicie. Przy cichszym sygnale pozostanie samo podbicie statyczne.
Warto pamiętać, że detektor reaguje na poziom sygnału w wybranym paśmie, a nie bezpośrednio na obecność mowy. Może więc działać inaczej przy cichych i głośnych fragmentach oraz różnych głoskach. Sposób i szybkość reakcji zależą od ustawionego progu i zakresu dynamiki, a czasy Attack i Release dobierane są automatycznie.
Takie ustawienie może pomóc kontrolować bas, ale nie zastępuje zwykłej korekcji. Warto najpierw ustawić bazową charakterystykę EQ, a dopiero później dodać korekcję dynamiczną.
Podstawowe zakresy częstotliwości głosu a jego brzmienie
Głos ludzki składa się z wielu składowych częstotliwości, które wspólnie kształtują jego barwę, głębię, naturalność i czytelność. Podczas korekcji audio w transmisji SSB warto wiedzieć, jakie znaczenie mają poszczególne zakresy i jakie problemy mogą wystąpić, gdy określone pasmo jest nadmiernie uwydatnione lub osłabione.
Poniższa tabela stanowi punkt wyjścia do analizy i korekcji głosu. Granice pasm są orientacyjne.
| Zakres częstotliwości | Wpływ na brzmienie głosu | Co można wstępnie ocenić |
|---|---|---|
| Poniżej 70 Hz | Bardzo niskie składowe, drgania mechaniczne, podmuchy i dudnienia | Często można ograniczyć bez istotnej utraty zrozumiałości mowy |
| 70-150 Hz | Podstawowy ciężar, głębia i niskie brzmienie głosu | Nadmiar może powodować buczenie i nadmiernie ciężki głos |
| 150-300 Hz | Pełnia, ciepło i masa głosu | Nadmiar może powodować dudnienie, mulistość i efekt „pudełkowego” brzmienia |
| 300-500 Hz | Niższy środek, korpus i naturalna barwa | Nadmiar może powodować wrażenie zamkniętego, mało przejrzystego dźwięku |
| 500-800 Hz | Średnie składowe wpływające na charakter i czytelność barwy | Nadmiar może nadawać głosowi nosowe lub telefoniczne zabarwienie, zależnie od szerszej charakterystyki |
| 800 Hz-1,5 kHz | Wyrazistość podstawowego brzmienia i część informacji istotnych dla rozpoznawania głosu | Zbyt mały udział może osłabiać czytelność; nadmiar może brzmieć twardo lub natarczywie |
| 1,5-3 kHz | Wyrazistość, obecność głosu i czytelność mowy | Ważny zakres dla zrozumiałości, szczególnie przy słabszym sygnale |
| 3-5 kHz | Atak głosek, szczegóły artykulacji i wrażenie jasności | Nadmiar może powodować ostrość i męczące brzmienie |
| Powyżej 5 kHz | Sybilanty, szum oddechu i najwyższe szczegóły głosu | W typowej transmisji SSB zakres ten może być ograniczony przez pasmo toru; jego znaczenie zależy od ustawionych filtrów |
Jak korzystać z tej tabeli?
Nie należy traktować jej jako gotowej recepty na korekcję. Jeśli głos brzmi zbyt ciężko, warto zacząć od sprawdzenia zakresów 70-300 Hz. Jeśli jest zamulony, należy ocenić również niższy środek, szczególnie 150-500 Hz. Jeżeli natomiast brakuje mu wyrazistości, warto sprawdzić zakres 1,5-3 kHz, zanim zacznie się mocno podbijać wysokie częstotliwości.
Ważne: zakresy nakładają się funkcjonalnie. Nie istnieją sztywne granice, według których jedna częstotliwość odpowiada wyłącznie za jedną cechę głosu. Ostateczny efekt zależy od widma głosu, jego harmonicznych, rezonansów traktu głosowego, mikrofonu oraz charakterystyki odbiornika.
W transmisji SSB celem nie jest uzyskanie idealnie płaskiego widma, lecz takie ukształtowanie sygnału, aby głos był czytelny w realnych warunkach odbioru.
Znajdź własne brzmienie
Nie ustawiaj modulacji tak jak wszyscy. Szukaj własnego stylu i brzmienia dopasowanego do Twojego głosu oraz słuchu - takiego, które podoba się przede wszystkim Tobie i które sam uważasz za właściwe. Celem nie jest kopiowanie cudzego presetu, lecz świadome ukształtowanie własnego sygnału.
Warto słuchać uwag korespondentów, zwłaszcza gdy kilka osób niezależnie i powtarzalnie zwraca uwagę na ten sam problem, na przykład nadmierną ostrość, nosowe brzmienie, dudnienie lub zbyt dużo basu. Potraktuj takie opinie jako wskazówkę do sprawdzenia, a nie gotowe ustawienia do skopiowania.
Jeśli prosisz kogoś o skonfigurowanie swojego toru audio, pamiętaj, że ta osoba może - nawet nieświadomie - kierować się własnym słuchem i preferencjami. Będzie więc dążyć do brzmienia, które jej odpowiada, często zbliżając Twój sygnał do charakteru własnej modulacji lub ustawień, które opracowała dla siebie. Nie musi to wynikać ze złej woli ani braku wiedzy: po prostu każdy ma swoje wyobrażenie o tym, jak głos powinien brzmieć. Ustawienia przygotowane przez kogoś mogą być dobrym punktem wyjścia, ale warto później samodzielnie ich posłuchać, porównać je i dopasować do własnego głosu oraz upodobań.
Gdy jedna osoba ustawia w podobny sposób wiele stacji, ich głosy mogą zacząć brzmieć do siebie podobnie pod względem barwy, mimo że operatorzy różnią się artykulacją, intonacją i sposobem wypowiedzi. To częsty przypadek słyszalny na pasmach. Powielanie jednego wzorca może zacierać indywidualny charakter poszczególnych modulacji i ograniczać różnorodność brzmień. Dlatego warto korzystać z cudzej wiedzy jako pomocy, ale ostateczne decyzje podejmować samodzielnie - z uwzględnieniem własnego głosu, odsłuchu i preferencji.
3. FabFilter Pro-DS Mono - de-esser
De-esser to procesor służący do kontrolowania nadmiernej energii sybilantów, czyli głosek syczących i szumiących, takich jak „s” i „sz”. Potocznie określa się je jako głoski „wysokie”, choć nie chodzi tu o wszystkie wysokie częstotliwości w sygnale.
W torze audio de-esser pełni trzy podstawowe funkcje:
- Ogranicza nadmierną ostrość głosek syczących.
- Zapobiega dominacji sybilantów nad pozostałą częścią wypowiedzi.
- Ogranicza niepotrzebne pobudzanie górnego pasma kompresora wielopasmowego.
Czego de-esser nie powinien robić?
Przede wszystkim nie powinien usuwać naturalnej ostrości mowy. Jeśli ustawisz zbyt niski próg (Threshold) lub zbyt dużą redukcję, głoski syczące stracą swoją naturalną strukturę. Modulacja może wtedy stać się sepleniąca, matowa i mniej wyraźna.
Pamiętaj, że de-esser nie służy do usuwania wysokich częstotliwości z głosu. Jego zadaniem jest kontrolowanie ich nadmiernej, chwilowej energii.
Zalecane wstępne ustawienia
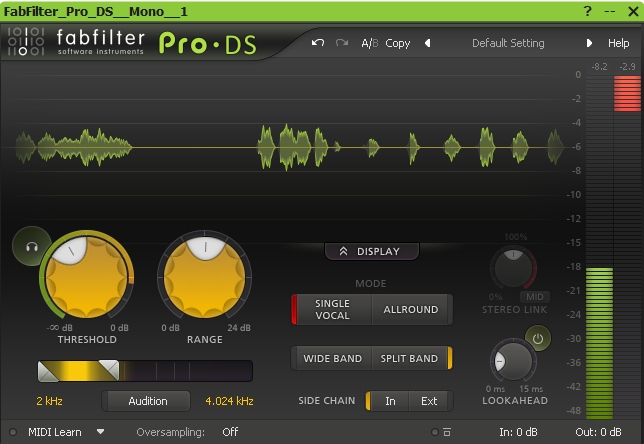
- Tryb: Single Vocal - właściwy tryb dla pojedynczego głosu.
- Przetwarzanie: Split Band może się sprawdzić, ale nie zawsze brzmi najlepiej na wokalu. FabFilter wskazuje, że dla pojedynczego głosu często dobrze sprawdza się również Wide Band. Split Band może wprowadzić dodatkową latencję, dlatego warto porównać oba tryby w odsłuchu.
- Zakres częstotliwości: 2-4 kHz lub wyżej, zależnie od szerokości pasma nadawania. To dość niski zakres względem typowych sybilantów, które często mają energię około 8-10 kHz. W SSB zakres może być ograniczony, dlatego ustaw filtry, korzystając z funkcji Audition Sidechain - tak, by de-esser reagował na sybilanty, a nie na całe brzmienie głosu.
- Lookahead: około 10 ms jako punkt wyjścia. Krótszy czas może nie wystarczyć do uchwycenia początku sybilantów; ustawienie dobierz podczas odsłuchu, aby nie wygładzić ich nadmiernie. Włączenie Lookahead zwiększa latencję.
- Oversampling: Off to rozsądny punkt wyjścia. Warto rozważyć jego włączenie, gdy de-esser pracuje często lub stosowana jest większa redukcja. Zmniejsza możliwe zniekształcenia aliasingowe, kosztem większego obciążenia CPU i niewielkiej dodatkowej latencji.
- Threshold i Range: dobierz tak, by redukcja przy sybilantach wynosiła około 3-3,5 dB (orientacyjny punkt startowy). Threshold ustaw tak, aby de-esser reagował na sybilanty, a Range ogranicza maksymalną redukcję. Oceniaj działanie zarówno na mierniku, jak i w odsłuchu.
4. FabFilter Pro-MB - kompresor wielopasmowy
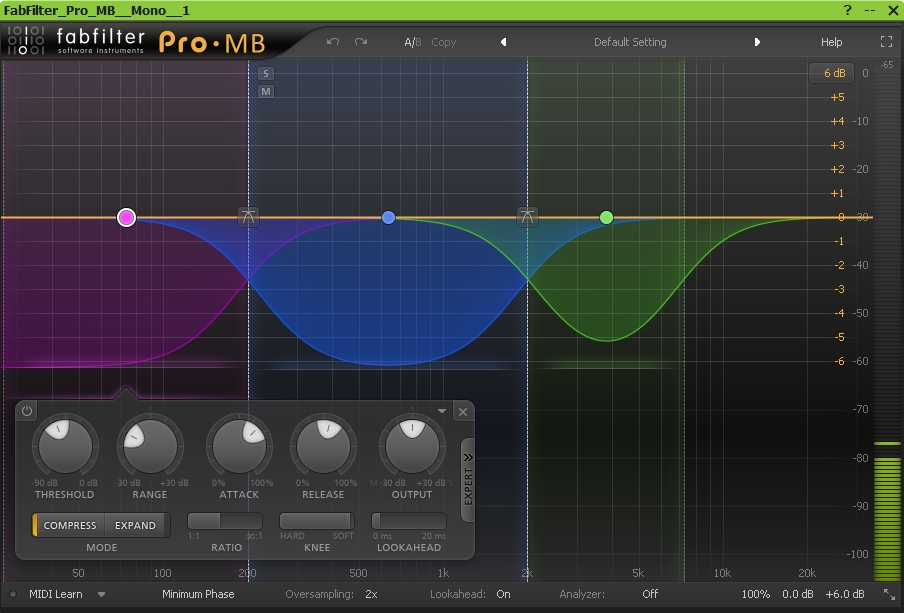
W teorii elektroakustyki kompresor wielopasmowy (multiband compressor) to układ, który dzieli sygnał wejściowy na kilka zakresów częstotliwości. FabFilter Pro-MB robi to zgodnie z naszymi wytycznymi, a następnie umożliwia niezależną kontrolę dynamiki każdego pasma. Oznacza to, że każde pasmo ma własny detektor dynamiki i oddzielne parametry kompresji.
- Threshold - próg zadziałania.
- Ratio - współczynnik kompresji.
- Attack - czas narastania redukcji wzmocnienia.
- Release - czas powrotu do normalnego wzmocnienia.
- Knee - charakterystyka przejścia w obszar kompresji.
- Makeup Gain - kompensacja poziomu po kompresji.
W uproszczeniu:
- Niskie pasmo - kontrola nadmiernej energii basu.
- Średnie pasmo - kontrola masy i dominujących częstotliwości głosu.
- Wysokie pasmo - kontrola ostrości i energii wysokich częstotliwości.
2. Jak teoria opisuje dobór częstotliwości podziału?
Nie istnieje jedna obowiązująca norma określająca częstotliwości podziału dla kompresji głosu. Granice pasm wynikają z celu przetwarzania i charakterystyki sygnału.
W praktyce uwzględnia się:
- Rozkład energii w widmie - w których zakresach występuje największa energia.
- Dynamikę poszczególnych zakresów - gdzie występują największe i najbardziej niepożądane wahania poziomu.
- Korelację zmian poziomu między pasmami - czy wzrost energii w jednym zakresie powinien wpływać na pozostałe.
- Charakterystykę materiału - głos o szerokim lub ograniczonym paśmie.
- Wpływ filtrów podziału - ich nachylenie, fazę i sposób rekonstrukcji sygnału po ponownym zsumowaniu.
Istotne jest rozróżnienie: częstotliwość podziału nie jest granicą między określonymi cechami głosu. Cechy te nie są od siebie całkowicie oddzielone.
3. Przykładowy podział na trzy pasma
Przykładowa konfiguracja może wyglądać następująco:
| Pasmo | Zakres częstotliwości |
|---|---|
| Niskie (LOW) | Poniżej 200 Hz |
| Średnie (MID) | 200 Hz-2 kHz |
| Wysokie (HIGH) | Powyżej 2 kHz |
Niezależna kontrola dynamiki
To istotna zaleta w porównaniu z kompresorem szerokopasmowym (Wideband Compressor). Wyobraźmy sobie, że wypowiadamy głoskę „S” i w sygnale pojawia się dużo energii w wysokich częstotliwościach.
Kompresor szerokopasmowy wykrywa wzrost poziomu i redukuje cały sygnał, więc razem z sybilantem ścisza również bas i środek. Kompresor wielopasmowy wykrywa wzrost energii w paśmie wysokim i może ograniczyć przede wszystkim ten zakres, pozostawiając bas i środek w większym stopniu bez zmian.
Analogicznie, gdy nadmierna energia pojawia się w innym paśmie, można kontrolować przede wszystkim ten zakres. Przy prawidłowym ustawieniu i odpowiednim wyrównaniu stopnia redukcji między pasmami pozwala to zachować większą stabilność tonalną głosu.
Natomiast zbyt intensywna, niezależna kompresja pasm może powodować zmienność barwy dźwięku w czasie.
W poszczególnych pasmach należy stosować różne czasy Attack i Release. Dzięki temu na przykład bas może być kompresowany wolniej, a wysokie pasmo szybciej. Pozwala to dopasować działanie kompresora do charakteru poszczególnych składowych mowy.
Częstotliwości podziału wybiera się tak, aby uzyskać pożądane zachowanie dynamiczne sygnału, z uwzględnieniem charakterystyki głosu oraz pożądanego efektu końcowego. Nie ma uniwersalnego podziału właściwego dla każdego głosu ani gatunku materiału audio.
Dobór parametrów kompresji w poszczególnych pasmach
W typowym przetwarzaniu mowy często przyjmuje się wolniejszy Release dla dołu, umiarkowany dla środka i szybszy dla góry. Niskie częstotliwości mają dłuższy okres przebiegu, zgodnie ze wzorem T = 1/f. Przykładowo, okres jednego cyklu wynosi 10 ms przy 100 Hz, 5 ms przy 200 Hz, 1 ms przy 1 kHz i 0,25 ms przy 4 kHz.
Przy niskich częstotliwościach zbyt szybkie zmiany wzmocnienia mogą powodować większe zniekształcenia przebiegu. Algorytmy kompresji często uwzględniają zależność czasową od przetwarzanego zakresu częstotliwości.
Warto rozdzielić dwie kwestie:
- Attack i Release określają zachowanie kompresora w czasie.
- Ratio, Threshold i Knee określają, jak silna będzie kompresja po przekroczeniu progu.
Poniższe zasady rozpatrujemy w kontekście mowy i kompresora FabFilter Pro-MB, jednak ogólne założenia można przenieść na inne urządzenia.
1. Attack - czas narastania kompresji
Attack określa, jak szybko kompresor rozpoczyna redukcję wzmocnienia po wykryciu sygnału przekraczającego próg.
- Zbyt szybki Attack: może ograniczać początek głosek, transjenty i energię artykulacyjną. Bardzo szybka modulacja wzmocnienia, szczególnie przy dużej redukcji w krótkim czasie, może również powodować zniekształcenia.
- Zbyt wolny Attack: pozwala krótkim impulsom przechodzić praktycznie bez kompresji, bo kompresor może nie zdążyć zareagować na krótkie skoki poziomu.
W przypadku mowy często stosuje się wolniejszy Attack w dole, aby nie reagować nadmiernie na każdy okres przebiegu niskiej częstotliwości. W środku zwykle sprawdza się bardziej umiarkowana reakcja, która kontroluje zmiany poziomu bez nadmiernego tłumienia początku głosek. W górze można zastosować szybszy Attack, jeśli celem jest kontrolowanie krótkich impulsów i ostrych elementów modulacji.
To sensowna tendencja startowa, natomiast poszczególne ustawienia należy dobrać samodzielnie.
2. Release - czas powrotu kompresora
Release określa, jak szybko kompresor zmniejsza redukcję wzmocnienia po ustaniu przyczyny kompresji. To parametr szczególnie istotny dla naturalności modulacji.
- Zbyt krótki Release: może powodować słyszalne modulowanie poziomu, zniekształcenia i efekt pompowania.
- Zbyt długi Release: kompresor może nadal tłumić sygnał, mimo że kolejny fragment wypowiedzi jest już cichszy. W rezultacie głos traci dynamikę i może brzmieć płasko.
3. Ratio - współczynnik kompresji
Ratio określa, jak mocno kompresor ogranicza wzrost poziomu po przekroczeniu progu. Przy Ratio 2:1, jeśli poziom wejściowy wzrośnie o 2 dB ponad Threshold, poziom wyjściowy wzrośnie o 1 dB ponad Threshold. Kompresor nie podbija więc sygnału — jego poziom nadal rośnie, ale wolniej niż bez kompresji.
W uproszczeniu poziom wyjściowy można obliczyć ze wzoru: Lout = T + (Lin - T) / R, gdzie Lout to poziom wyjściowy, Lin - poziom wejściowy, T - Threshold, a R - Ratio.
Przykładowo, jeśli sygnał wejściowy przekracza Threshold o 6 dB, przy Ratio 2:1 sygnał wyjściowy znajdzie się 3 dB ponad Threshold. To o 3 dB mniej niż wyniósłby poziom wyjściowy bez kompresji. Dla różnych wartości Ratio wygląda to następująco:
| Ratio | Poziom wyjściowy ponad Threshold | Redukcja względem sygnału bez kompresji |
|---|---|---|
| 1,5:1 | 4 dB | 2 dB |
| 2:1 | 3 dB | 3 dB |
| 3:1 | 2 dB | 4 dB |
| 4:1 | 1,5 dB | 4,5 dB |
Jeśli celem jest naturalne wyrównanie dynamiki mowy, zwykle zaczyna się od umiarkowanych wartości Ratio, na przykład 1,5:1-2:1. Większe Ratio stosuje się, gdy potrzebna jest silniejsza kontrola. Dobór Ratio zależy od tego, jak mocno chcemy ograniczać dynamikę danego pasma.
4. Knee - charakterystyka wejścia w kompresję
Knee określa, jak stopniowo kompresor przechodzi od pracy bez kompresji do pełnego działania zgodnego z ustawionym Ratio.
- Hard Knee: kompresja zaczyna działać wyraźnie po przekroczeniu Threshold; charakterystyka jest bardziej zdecydowana.
- Soft Knee: kompresja narasta stopniowo w pobliżu Threshold, dzięki czemu przejście jest łagodniejsze.
W przetwarzaniu mowy Soft Knee często pomaga ograniczyć słyszalność samego procesu kompresji. Hard Knee może być przydatny, gdy chcemy kontrolować konkretne, wyraźne skoki poziomu.
5. Lookahead - wyprzedzenie detekcji
Lookahead pozwala kompresorowi rozpocząć reakcję przed momentem, w którym sygnał zostanie faktycznie przetworzony.
Lookahead nie jest tym samym co Attack. Lookahead pozwala rozpocząć tę reakcję wcześniej. Dzięki temu można skuteczniej kontrolować krótkie impulsy bez konieczności ustawiania ekstremalnie szybkiego Attack.
W mowie zazwyczaj nie ma potrzeby stosowania dużego Lookahead. Można zacząć od 0-3 ms i sprawdzić, czy krótkie piki są lepiej kontrolowane. Większe wartości mają sens wtedy, gdy rzeczywiście potrzebujesz wcześniejszej reakcji. W Pro-MB Lookahead można ustawić do 20 ms, a jego włączenie powoduje dodatkową latencję.
6. Jak działają czasy Attack i Release w Pro-MB?
W FabFilter Pro-MB Attack i Release nie są prezentowane w milisekundach, lecz w procentach od 0 do 100%. Nie można więc bezpośrednio przenieść ustawień czasowych z klasycznego kompresora, na przykład Pro-C 2.
FabFilter stosuje charakterystyki zależne od materiału i przetwarzanego zakresu częstotliwości. Rzeczywiste czasy reakcji zależą między innymi od położenia pasma w widmie. Oznacza to, że 50% Attack w paśmie niskim nie musi odpowiadać czasowo 50% Attack w paśmie wysokim. Procentów nie należy traktować jako liniowej skali milisekund.
7. Zestawienie teoretyczne dla mowy
Poniższa tabela przedstawia typową tendencję, a nie obowiązkowy preset:
| Parametr | Dół | Środek | Góra |
|---|---|---|---|
| Attack | Wolniejszy | Umiarkowany | Szybszy |
| Release | Wolniejszy | Umiarkowany | Szybszy |
| Ratio | Umiarkowane | Umiarkowane | Umiarkowane |
| Knee | Raczej Soft | Raczej Soft | Raczej Soft |
| Lookahead | Według potrzeb | Według potrzeb | Według potrzeb |
8. Co jest najważniejsze w praktyce?
Przy przetwarzaniu głosu do SSB/eSSB kolejność podejmowania decyzji może być następująca:
- Threshold - ustalasz, przy jakim poziomie kompresor zaczyna reagować.
- Ratio - określasz siłę kompresji.
- Attack - decydujesz, jak szybko ma narastać redukcja.
- Release - decydujesz, jak szybko kompresor ma wracać do normalnego wzmocnienia.
- Knee - określasz łagodność przejścia w kompresję.
- Lookahead - dodajesz wyprzedzenie, jeśli jest potrzebne do kontroli krótkich impulsów.
Wykaz przykładowych ustawień Attack i Release
Wartości Attack i Release są ustawieniami procentowymi i nie odpowiadają bezpośrednio wartościom w milisekundach - tak dla przypomnienia.
Przykładowe ustawienia:
| Parametr | Bas | Środek | Góra |
|---|---|---|---|
| Attack | 64% | 45% | 22% |
| Release | 55% | 45% | 30% |
| Ratio | 2,1:1 | 1,5:1 | 1,7:1 |
| Knee | 48 dB | 48 dB | 48 dB |
Dół ma wolniejszą reakcję, środek umiarkowaną, a góra szybszą. To sensowny początkowy preset dla obróbki głosu w ESSB.
Czy Attack i Release powinny być do siebie zbliżone?
Nie ma reguły, która wymaga identycznych wartości Attack i Release. Kompresor powinien wystarczająco szybko reagować na niepożądany wzrost poziomu, a następnie płynnie wracać do normalnego wzmocnienia, bez słyszalnego pompowania.
Przy Attack 22% i Release 20% kompresor szybko rozpoczyna redukcję i stosunkowo szybko z niej wychodzi. Może dobrze kontrolować krótkie impulsy, ale przy zbyt intensywnej pracy powodować słyszalne zmiany barwy i poziomu. Przy Attack 22% i Release 45% kompresor również szybko reaguje, ale wolniej odzyskuje wzmocnienie. Może zapewnić stabilniejsze wyrównanie poziomu, lecz przy kolejnych głoskach utrzymywać redukcję zbyt długo.
Nie ma więc zasady, że Release musi być taki sam jak Attack. Najważniejsze jest zachowanie kompresora w czasie naszej wypowiedzi. Można je obserwować na ekranie i dobrać czas tak, aby uzyskać możliwie gładką pracę w danym paśmie - zarówno wizualnie, jak i na słuch.
Czy Release 20% na górze ma sens?
Przy górnym paśmie krótkie elementy artykulacyjne, takie jak spółgłoski szczelinowe, mogą wymagać szybszego odzyskiwania wzmocnienia. Jeśli jednak Release będzie zbyt szybki, działanie kompresora może stać się słyszalne. Dlatego 20% nie jest automatycznie lepsze od 25%.
Przy identycznym materiale wejściowym porównaj brzmienie i sprawdź, kiedy dźwięk jest bardziej wygładzony, a kiedy zyskuje ostrość. Postaw na naturalność głosek i stabilność barwy.
Czy Attack i Release powinny mieć taki sam czas?
Nie. Attack i Release opisują dwa różne procesy i nie muszą być symetryczne. Dla mowy często korzystne jest odpowiednio szybkie rozpoczęcie redukcji oraz płynny powrót, który nie powoduje pompowania. Release nie zawsze powinien być wolniejszy: przy krótkich, dynamicznych elementach mowy szybszy powrót może być korzystniejszy, ale trzeba uważać, aby nie wywołać efektu pompowania. Na początek zalecam ustawić wyraźnie różne wartości, aby łatwiej wychwycić różnicę w odsłuchu, a następnie stopniowo zmniejszać tę różnicę. Nie od razu będziemy umieli wszystko ocenić na słuch. Niektóre rzeczy wymagają praktyki i osłuchania.
Knee 48 dB
48 dB to bardzo szeroki zakres miękkiego kolana. Knee określa łagodność przejścia między sygnałem niekompresowanym a kompresowanym. Im miększe kolano, tym bardziej stopniowo kompresor zaczyna działać w pobliżu Threshold. Przy mowie takie ustawienie może być uzasadnione, jeśli zależy nam na łagodnym wyrównywaniu dynamiki.
9. Tryby przetwarzania Pro-MB
FabFilter Pro-MB oferuje trzy tryby przetwarzania fazy, które w różny sposób realizują podział pasma i przetwarzanie dynamiczne.
Dynamic Phase
- Gdy nie zachodzi redukcja wzmocnienia, charakterystyka fazowa pozostaje liniowa.
- Zmiany fazy pojawiają się podczas dynamicznej zmiany wzmocnienia.
- Tryb nie powoduje pre-ringuingu ani dodatkowej latencji wynikającej z samego trybu.
- Według FabFilter jest to najbardziej przezroczysty tryb przetwarzania.
Minimum Phase
- Wykorzystuje tradycyjne filtry podziału pasma.
- Wprowadza statyczne zmiany fazy w okolicach częstotliwości podziału.
- Nie powoduje dodatkowej latencji, ale przy stromych zboczach mogą występować większe zmiany fazowe.
Linear Phase
- Zachowuje liniową charakterystykę fazową po podziale i ponownym zsumowaniu pasm.
- Wprowadza dodatkową latencję.
- Może powodować pre-ringing, czyli niewielkie oscylacje poprzedzające impuls.
Co oznacza to dla sygnału mono?
Mono nie oznacza, że faza przestaje mieć znaczenie. Nie ma tu kwestii obrazowania stereo, szerokości sceny ani relacji fazowej między kanałami L/R, odpada więc część problemów typowych dla masteringu stereo. Nadal jednak filtry wpływają na kształt sygnału monofonicznego.
W tym zastosowaniu Dynamic Phase jest rozsądnym wyborem, ponieważ nie wprowadza statycznych zmian fazowych przy braku redukcji, nie powoduje pre-ringuingu i nie wymaga dodatkowej latencji wynikającej z samego trybu. Linear Phase nie daje automatycznej poprawy jakości, a przy mocnych impulsach spółgłosek pre-ringing może być niepożądany.
10. Oversampling: 2× czy 4×?
Oversampling zwiększa wewnętrzną częstotliwość próbkowania podczas przetwarzania. Przy częstotliwości próbkowania projektu 48 kHz wartości wyglądają następująco:
| Oversampling | Wewnętrzna częstotliwość przetwarzania |
|---|---|
| 1× | 48 kHz |
| 2× | 96 kHz |
| 4× | 192 kHz |
Po przetwarzaniu sygnał jest ponownie sprowadzany do częstotliwości próbkowania projektu. Szybkie zmiany wzmocnienia mogą wprowadzać dodatkowe składowe widmowe. Jeśli wykraczają one poza częstotliwość Nyquista, mogą powstać produkty aliasingu. Przy próbkowaniu 48 kHz częstotliwość Nyquista wynosi 24 kHz.
Oversampling ogranicza aliasing, ponieważ algorytm pracuje wewnętrznie z wyższą częstotliwością próbkowania. FabFilter wskazuje, że jest on bardziej przydatny przy szybkich czasach Attack i Release, dużym Ratio, intensywnej kompresji lub ekspansji oraz dużym zakresie zmian wzmocnienia (Range). Dodatkowo poprawia odpowiedź wysokoczęstotliwościową trybów Dynamic Phase i Minimum Phase w pobliżu częstotliwości Nyquista.
Większy oversampling zwiększa obciążenie CPU i może dodawać latencję. Źródło: dokumentacja oversamplingu FabFilter Pro-MB.
11. Rekomendowane ustawienia Pro-MB
Jako punkt wyjścia dla tego głosu proponuję:
| Parametr | Ustawienie |
|---|---|
| Processing Mode | Dynamic Phase |
| Oversampling | 2× |
| Lookahead | Według potrzeb, nie dla samej poprawy jakości |
| Sample Rate | 48 kHz |
Samo ograniczenie pasma sygnału do 5 lub 6 kHz nie gwarantuje braku aliasingu. Kompresja jest procesem nieliniowym i może generować dodatkowe składowe. Nie twierdzę więc, że oversampling 2× niczego nie zmienia. W moich warunkach prawdopodobnie nie zmienia niczego istotnego dla odbiorcy.
Pozostawiłbym oversampling 2×. Ustawienie 4× nie oznacza automatycznie dwukrotnie lepszej jakości niż 2×: zwiększa częstotliwość wewnętrznego przetwarzania i może bardziej ograniczyć aliasing, ale również zwiększa obciążenie CPU i latencję.
Przy moich wartościach Ratio: dół 2,1:1, środek 1,5:1 i góra 1,7:1, oversampling 2× jest sensownym ustawieniem początkowym.
Podsumowanie Pro-MB
Opisane parametry i ich ustawienia nie są sztywną doktryną do stosowania w każdych warunkach, lecz punktem wyjścia do eksperymentów. Nie jestem inżynierem ani specjalistą od dźwięku. Opis opieram częściowo na dokumentacji technicznej FabFilter, a także na własnym doświadczeniu i eksperymentach oraz dopasowywaniu brzmienia i charakterystyki całego toru audio do własnych preferencji. Proponowane ustawienia mają pomóc rozpocząć pracę od punktu, który może się sprawdzić, oraz zrozumieć funkcję poszczególnych parametrów.
Można eksperymentować z dwoma, trzema albo pięcioma pasmami podziału. Warto słuchać i porównywać różne ustawienia. Nie wszystko da się usłyszeć od razu. Rozpoznawanie subtelnych różnic wymaga praktyki i osłuchania. Sam przez długi czas miałem trudność z wychwyceniem nawet dużych różnic między działaniem kompresora jednopasmowego i trzypasmowego. Z czasem coraz łatwiej je zauważać i samodzielnie dopasowywać brzmienie do własnych upodobań oraz warunków na paśmie. Można też przygotować kilka presetów i przełączać je zależnie od sytuacji.
Pamiętaj, obserwuj nie tylko moment, w którym kompresor zaczyna redukować sygnał, ale też to, co dzieje się między kolejnymi głoskami i sylabami. Jeśli redukcja nie zdąży wrócić przed kolejnym fragmentem wypowiedzi, może pojawić się efekt ciągłego tłumienia. Jeśli wraca za szybko, możesz usłyszeć modulowanie barwy.
Obserwacja zachowania i odsłuch kompresora na nagraniu własnego głosu są bardziej miarodajne i szybsze niż próba wyliczania Attack i Release z samych procentów.
5. FabFilter Pro-L 2- limiter czyli kontrola szczytowego poziomu.
Limiter jest procesorem dynamiki, którego zadaniem jest ograniczenie maksymalnego poziomu sygnału audio do określonej wartości granicznej (Ceiling). W przeciwieństwie do standardowego kompresora, który stopniowo zmniejsza dynamikę sygnału po przekroczeniu ustalonego progu, limiter działa zdecydowanie, zapobiegając przekroczeniu zadanego poziomu szczytowego.
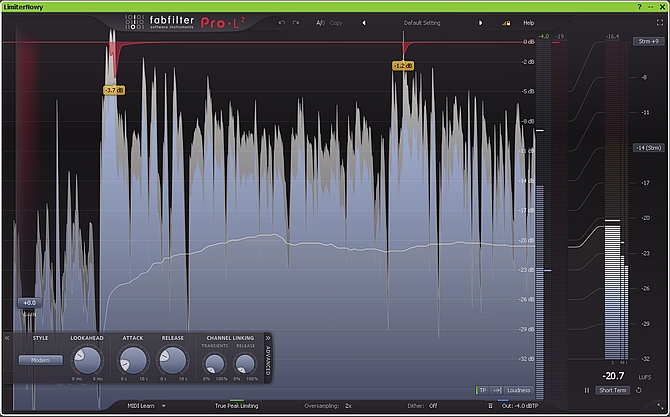
Limiter nie powinien zastępować kompresji dynamiki. Nie powinien ciągle wyrównywać poziomu głosu. W transmisji SSB/eSSB pozwala to zachować naturalną dynamikę mowy, jednocześnie ograniczając ryzyko przesterowania toru nadawczego.
Najważniejsze parametry limitera:
- Ceiling - określa maksymalny dopuszczalny poziom sygnału wyjściowego.
- Lookahead - umożliwia wcześniejsze wykrycie nadchodzącego szczytu i przygotowanie odpowiedniej redukcji wzmocnienia.
- Attack - określa szybkość narastania redukcji wzmocnienia.
- Release - określa czas powrotu do normalnego poziomu wzmocnienia po ustąpieniu szczytu.
- True Peak Limiting - uwzględnia możliwość występowania szczytów między próbkami cyfrowymi, które mogą przekroczyć poziom wynikający z samych próbek.
Różnica w tych nastawach jest dość konkretna: regulując Ceiling, zmieniasz maksymalny poziom sygnału na wyjściu limitera.
| Output / Ceiling | Maksymalny poziom liniowy |
|---|---|
| −1 dBFS | 0,891 |
| −4 dBFS | 0,631 |
| −8 dBFS | 0,398 |
Co to oznacza w praktyce?
- −1 dBFS – sygnał może osiągać wysoki poziom cyfrowy. Mały zapas do pełnej skali.
- −4 dBFS – pozostawiasz 4 dB zapasu.
- −8 dBFS – pozostawiasz 8 dB zapasu, czyli znacznie obniżasz poziom wyjściowy.
Przy niezmienionym Gain i tym samym sygnale obniżenie Ceiling z −1 do −8 dB oznacza, że limiter musi ograniczyć szczyty o dodatkowe 7 dB.
Przykładowe ustawienia limitera:
| Parametr | Ustawienie |
|---|---|
| Style | Modern |
| Lookahead | 1,55 ms |
| Attack | 1,8 ms |
| Release | 165 ms |
| Oversampling | 2× |
| Dither | Off |
| True Peak Limiting | On |
| Gain | 0 dB |
| Maksymalna chwilowa redukcja | Około 3 dB |
Jeżeli limiter redukuje wzmocnienie tylko sporadycznie, podczas pojedynczych szczytów, pełni funkcję zabezpieczenia przed pikami i tak powinien pracować, aby nie wprowadzać dodatkowej kompresji w torze. Następnie, na samym końcu naszego łańcucha audio, ustalamy poziom wejściowy do radiostacji tak, aby mieścił się w optymalnym zakresie, nie powodował pików ALC ani przesterowania na wejściu.